CRM que se molda ao processo
Gume
O CRM que acompanha o seu processo comercial, pronto para agentes de IA via MCP, com API pública e plano gratuito para começar.
- commits em 8 semanas
- 621
- ADRs (registros de decisão)
- 48
- arquivos de teste
- 531
- operações na API pública
- 170
Números medidos no repositório.
Contexto e problema
Time comercial passa o dia dentro do CRM, mas quase nunca dentro de um CRM que acompanha o processo dele. Campo novo vira chamado, funil novo vira projeto, e automação é caixa-preta: ninguém sabe o que ela vai fazer até ela fazer, em produção.
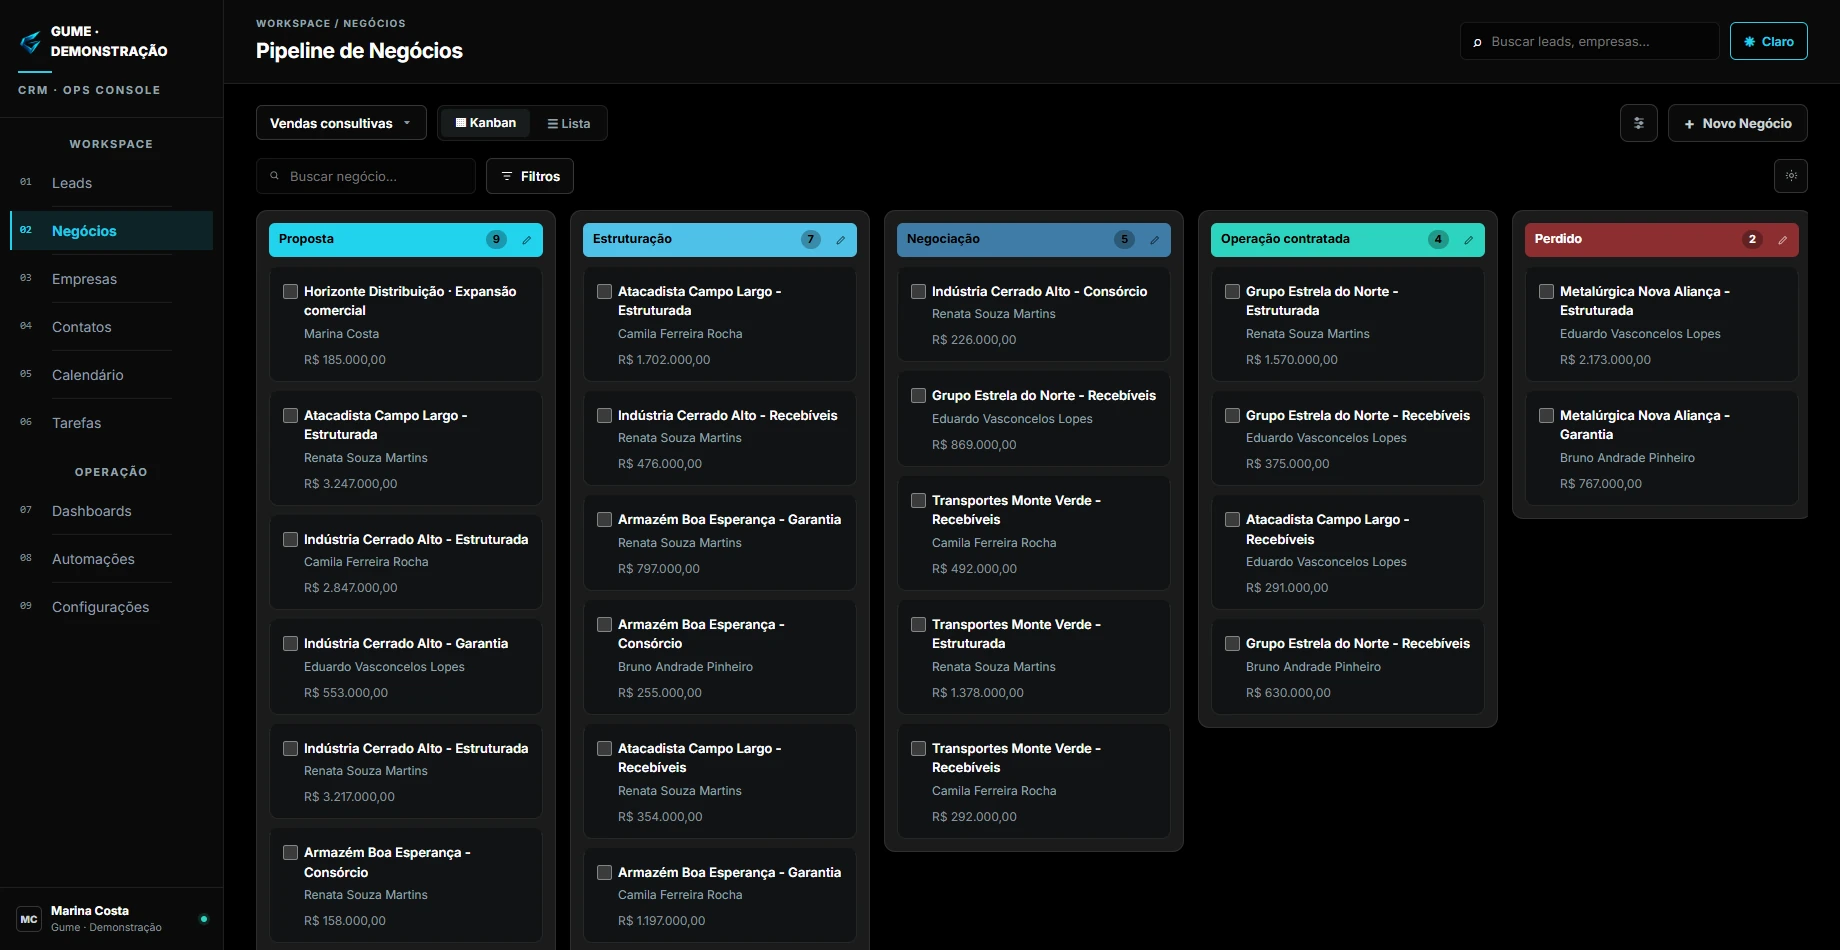
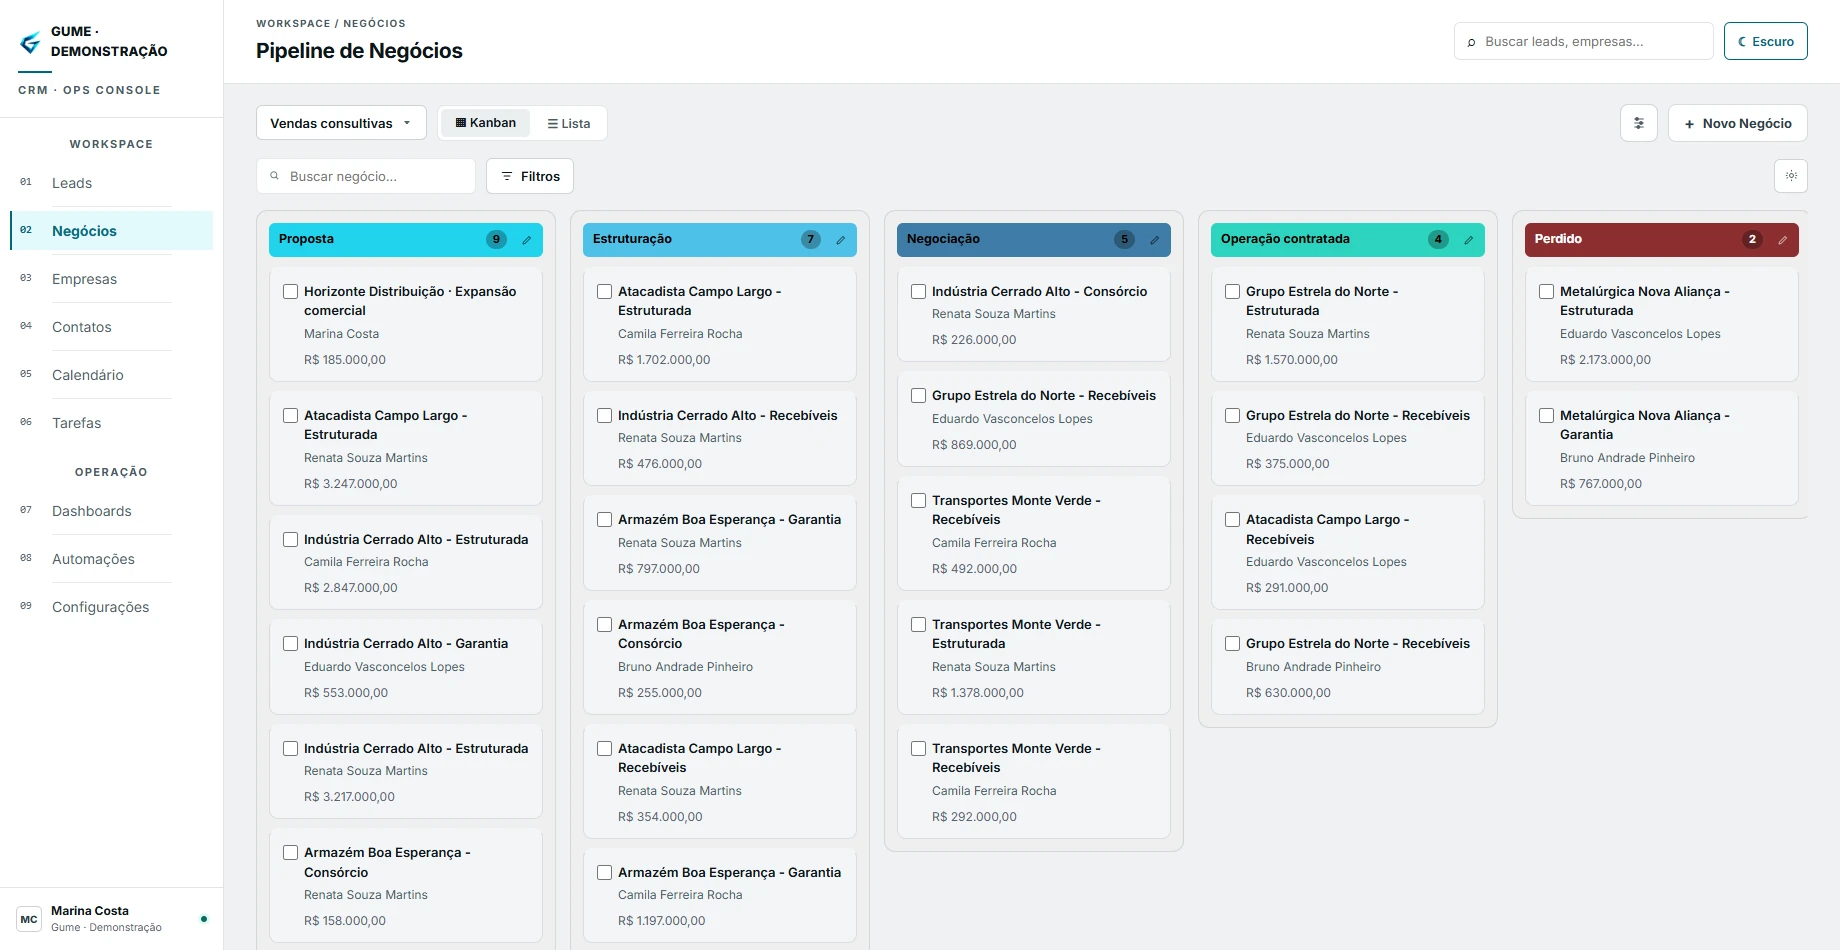
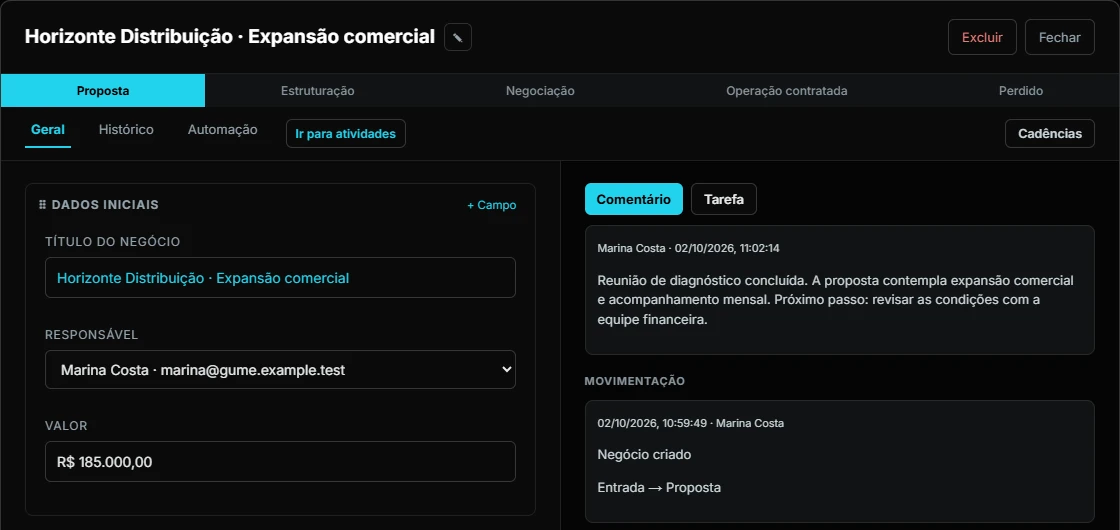
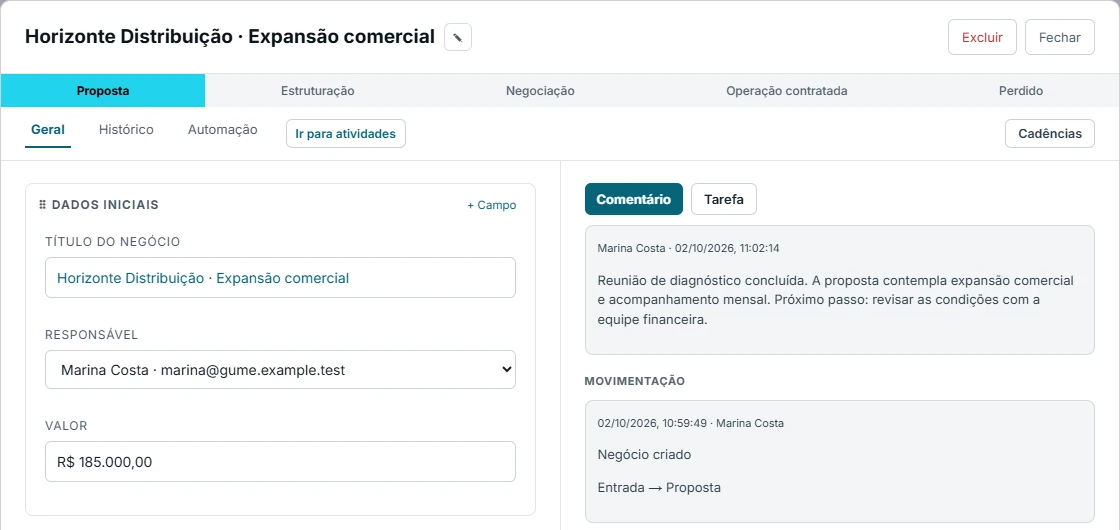
O Gume é o meu produto para esse problema, um CRM SaaS que estou levando ao mercado em gume.app.br. A proposta é um CRM em português para equipes que querem configurar o próprio processo: funil em kanban, detalhe e histórico de cada negócio, funis e campos próprios, automações visuais, API documentada, importação de CSV, permissões por pessoa e histórico de alterações. A interface sai em português, inglês e espanhol, e o cadastro aceita conta Google ou Microsoft. Existe um plano gratuito com limites (3 usuários, 5.000 registros, 3 automações ativas, 500 execuções por mês e 500 MB). Os planos pagos ainda estão em definição.
O código é fechado e o produto é comercial. Por isso este case descreve a engenharia em texto, sem trechos de código. Os blocos “Detalhes técnicos” abrem com um clique, para quem quiser ver como cada parte funciona por dentro.
Restrições que eu me impus
- Vários clientes no mesmo banco, e nenhum caminho de leitura ou escrita pode cruzar workspaces. A autorização acontece sempre no servidor; a interface só reflete o que o servidor decidiu.
- PostgreSQL é a única fonte da verdade. Redis guarda só limite de requisições e coordenação de curta duração, e perder o Redis não pode apagar nada.
- Configurar não pode exigir migração. Criar um campo é escrita de metadado, nunca
ALTER TABLE. - Automação tem que ser previsível. O usuário precisa ver o que um fluxo faria antes de publicar.
- O produto inteiro precisa caber num servidor só e barato, com backup verificado e monitoramento, enquanto não houver receita que justifique mais.
- Soft delete por padrão, dinheiro em
NUMERICe um histórico de alterações gravado junto com cada escrita.
Decisões que definiram o produto
Arquitetura
Toda escrita passa pela API e grava estado, auditoria e evento de outbox na mesma transação do PostgreSQL. Só depois do commit o worker consome o evento e aciona automações, webhooks e integrações. Agentes de IA usam o MCP, que fala com a mesma API REST e nunca com o banco.Se um provedor externo falhar, o evento continua no outbox e o worker reprocessa com consumidores idempotentes. A escrita do usuário nunca depende de terceiros, e perder o Redis não apaga dados do CRM.
Em produção, um proxy de borda roteia /api/v1/* direto para a API e o resto para o Next.js. O worker consome o outbox, executa automações e roda as rotinas de retenção. O servidor MCP roda na máquina de quem usa, sem acesso ao banco nem regra de negócio: ele traduz ferramentas em chamadas à mesma API REST, com uma chave de serviço com escopo.
Detalhes técnicos: o SaaS inteiro numa VPS de 6 vCPU e 12 GiB7 processos · backup diário
A produção é um único host Linux com 6 vCPU e 12 GiB de RAM rodando sete processos em contêineres: borda, web, API, worker, PostgreSQL, Redis e MinIO. Só a borda publica portas (80 e 443). O resto fica numa rede privada, e o PostgreSQL escuta apenas no loopback, para o backup.
O orçamento de memória está escrito num contrato de topologia que o CI confere: 3 GiB para o PostgreSQL, 1,5 GiB para a API, 768 MiB para o web, 512 MiB para worker e MinIO, 384 MiB para o Redis e 128 MiB para a borda. Sobram cerca de 5,25 GiB para sistema operacional, runtime de contêiner e cache de disco. O Redis roda com noeviction: se a memória acabar, ele recusa a escrita em vez de descartar um contador de limite em silêncio.
O backup roda todo dia: pg_dump, criptografia com age e envio para um bucket S3 versionado. A identidade que produz o backup só consegue gravar; quem apaga cópias antigas é outra conta, com outra credencial, e a chave privada de restauração fica fora do servidor. Cada execução grava um manifesto com hash, tamanho e a última migração aplicada, e só avisa o monitor de sucesso depois de verificar o snapshot. Se o aviso não chega em 26 horas, recebo um alerta. Um ensaio de restauração completo (dump, criptografia, upload, download da versão exata, decriptação e restore num banco vazio) roda no CI.
O deploy é um script que guarda um dump antes de cada release (mantido por 90 dias) e tem caminho de rollback. Para saúde do host, um agente pequeno lê /proc e o Docker a cada 60 segundos e manda um snapshot para a própria API, guardado por 30 dias no PostgreSQL. Escolhi isso no lugar de Prometheus e Grafana porque um stack de observabilidade completo custaria mais memória que o próprio worker.
O que o produto entrega por dentro
Modelo de dados e campos customizados
Leads, negócios, empresas, contatos, tarefas e produtos são objetos nativos, com colunas especializadas. Por cima deles, cada workspace cria campos próprios sem migração.
Detalhes técnicos: valores tipados, chaves compostas e índices por workspaceADR-0006 · ADR-0015
Uma definição de campo tem UUID imutável, tipo de dono (lead, negócio, empresa ou contato), chave de máquina, tipo de valor e cardinalidade única ou múltipla. Os valores ficam em linhas ordenadas numa tabela compartilhada. Cada linha repete o tipo de dono, o tipo de valor e a cardinalidade da definição sob uma chave estrangeira composta, e um check exige que só a coluna tipada correspondente esteja preenchida. O banco recusa um texto num campo de número mesmo que a aplicação erre.
Tipo e cardinalidade não mudam depois de criados. Mudança incompatível vira campo novo mais uma migração de dados explícita, para que linhas antigas nunca sejam reinterpretadas. Apagar uma definição é lógico e preserva os valores. Referências a outro registro ou a um membro do workspace são polimórficas, então um adaptador registrado por entidade trava e valida o alvo na mesma transação; referência para outro workspace falha.
Filtros exatos e por faixa usam índices B-tree compartilhados que começam por workspace, definição e valor tipado, sem índice dinâmico por cliente. Busca aproximada não é prometida até um plano de consulta medido justificar o custo. Há limites rígidos por campo, por valor e por requisição, porque campo múltiplo multiplica linhas e o tamanho do histórico.
O isolamento entre clientes segue a mesma ideia: as tabelas carregam workspace_id, e as chaves estrangeiras compostas incluem o workspace, de modo que essas relações não conseguem apontar para dado de outro cliente nem por erro de aplicação. Por cima disso, serviços e repositórios conferem o workspace de novo depois da autorização da rota.
Automações e simulação
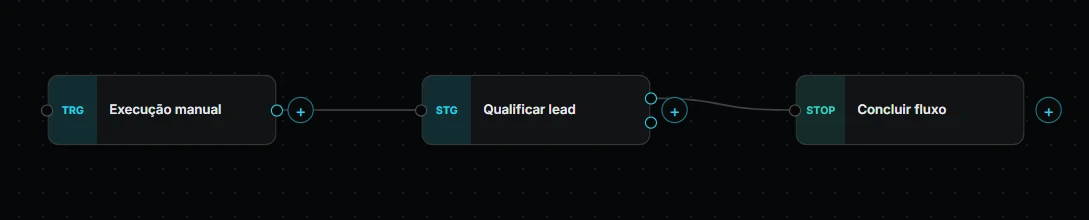
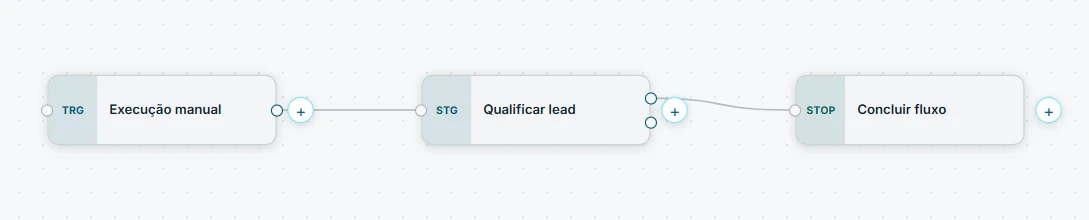
O canvas visual monta fluxos com gatilho, condições, ações no CRM, espera e chamada HTTP. Antes de publicar, o usuário roda uma simulação que mostra o que cada passo faria.
Detalhes técnicos: versões, esperas duráveis e simulação com estado-sombradraft/published · fixtures
Cada automação tem rascunho e versões publicadas, e uma execução fica presa à versão que estava publicada quando o gatilho disparou. Editar o fluxo não muda o que já está rodando.
Espera é estado persistido. A execução vai para WAITING com um horário de retomada, e o agendador de cadências acorda as que venceram com FOR UPDATE SKIP LOCKED, para dividir o trabalho sem duas instâncias pegarem a mesma linha. Espera em dias úteis fixa a versão do calendário no momento do agendamento. Na retomada, a condição de cancelamento é avaliada contra o registro atual, então um negócio que já foi ganho não recebe o follow-up que estava agendado.
A simulação recebe só portas de leitura do workspace, um estado-sombra em memória que as ações simuladas alteram e um resolvedor de fixtures HTTP. Um passo HTTP só “funciona” se a requisição trouxer a fixture exata daquele nó; sem ela, a simulação devolve uma negação antes de qualquer adaptador de rede existir no caminho. Esperas viram tempo virtual. O resultado é um trace versionado com o registro antes e depois, e nada fica gravado: duas simulações iguais dão o mesmo resultado lógico e não deixam rastro no banco.
O plano entra aqui também. Execuções contam num contador mensal por workspace; acima do limite, a execução não é criada, o gatilho fica marcado como barrado pelo plano e não é reprocessado, e um único evento de auditoria por mês registra que o teto foi atingido.
Eventos, outbox e worker
Webhooks de saída, automações e integrações saem do outbox, nunca da requisição do usuário.
Detalhes técnicos: claims idempotentes, leases e webhooks assinadosoutbox · at-least-once
O worker lê eventos já commitados e processa cada um numa transação que faz duas coisas juntas: insere o claim do evento (com conflito ignorado) e grava o efeito. Se o processo morrer no meio, não sobra claim sem efeito nem efeito sem claim. Execuções de automação usam lease com token e prazo; um worker que perdeu o lease não consegue gravar o resultado de um passo. O loop de polling volta imediatamente quando a última passada encontrou trabalho, para drenar fila acumulada sem esperar o intervalo ocioso.
Webhook de saída congela o corpo canônico do evento, assina cada tentativa com HMAC, tem identidade estável para o receptor deduplicar, retry com backoff, fila de mortos e reenvio manual pelo administrador. A chamada de rede acontece num consumidor próprio, fora do consumidor interno do outbox, que só mexe no PostgreSQL. Webhook de entrada valida a assinatura do endpoint, grava um recibo idempotente e o evento no outbox e só então responde 202; a execução é criada depois, de forma assíncrona.
O mesmo worker roda de hora em hora a rotina de retenção de dados pessoais, em lotes de 1.000 linhas e usando o relógio do banco: corpos de webhook e de e-mail, linhas brutas de importação e saídas de passos de automação são anulados ou redigidos em janelas que vão de 7 dias a 12 meses, e trilhas antigas são apagadas.
Acesso: login, permissões e chaves de API
Cada pessoa entra com e-mail e senha, Google ou Microsoft. O administrador define o que cada membro pode ver e alterar, e integrações usam chaves com escopo.
Detalhes técnicos: sessão no servidor, perfis que falham fechados e admissão em RedisArgon2id · HMAC · 5 buckets
A sessão é um token opaco num cookie HttpOnly; o banco guarda só um digest com chave, e cada requisição resolve usuário e membership no PostgreSQL. Senha usa Argon2id. Mutações do navegador exigem Origin exata e token CSRF. Conta Google é identificada pelo sub verificado e conta Microsoft por tenant mais sub; colisão de e-mail na Microsoft falha em vez de vincular contas. Um hub único faz login e escolha de ambiente, e a passagem entre hosts usa um handoff de uso único guardado no Redis; o host de destino cria a própria sessão no PostgreSQL.
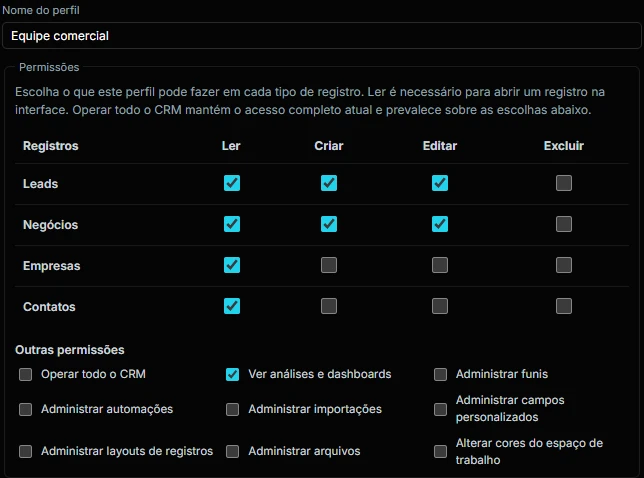
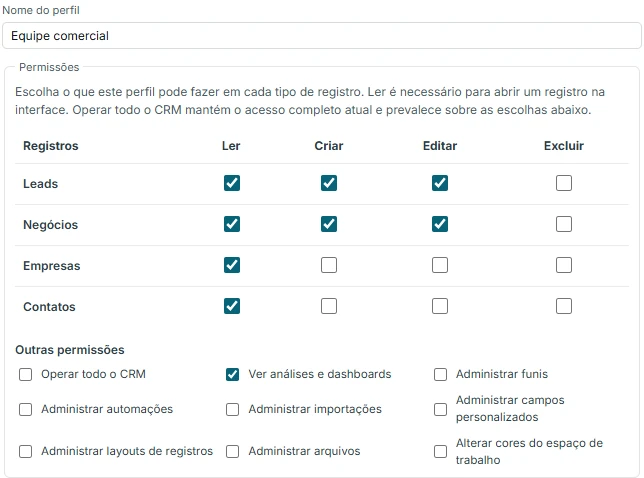
Os papéis são administrador e membro. Membros podem receber um perfil nomeado com capacidades de leitura, criação, edição e exclusão separadas para lead, negócio, empresa e contato (16 combinações). Perfil vazio, desativado ou apagado concede nada, nunca o padrão. As capacidades são resolvidas na mesma transação da requisição, sem cache, então tirar um acesso vale na próxima chamada.
Chaves de API são opacas, aparecem uma vez, têm validade obrigatória e são verificadas por HMAC com um keyring de pepper que permite rotação. Só um administrador logado por cookie cria, gira ou revoga chaves; uma chave não administra outra. Requisição com cookie e Bearer ao mesmo tempo é recusada. Todo endpoint precisa estar classificado no registro de rotas, com capacidade humana e escopo de serviço, ou a API não sobe; o OpenAPI é gerado desse registro.
O limite de requisições por chave é uma janela fixa em Redis. Um script atômico confere e incrementa cinco contadores de uma vez (versão da chave, principal, workspace, rota e classe de tráfego) ou não incrementa nenhum, e nada é devolvido depois de admitido. Se o Redis falhar, só o tráfego de chaves recebe 503; quem está no navegador continua lendo.
API e servidor MCP
A API é a mesma superfície que o app e os agentes usam, documentada em OpenAPI 3 e publicada com referência interativa, llms.txt e exportação “copiar para IA”. A especificação pública tem 170 operações em 136 rotas. Algumas escolhas que tornam integrações difíceis de quebrar:
- Mudar um negócio de etapa tem endpoint próprio (
POST .../stage-transitions). O update comum não aceita etapa, e o histórico de movimentação é imutável. - Updates aceitam
expected_updated_at. Se alguém editou antes, a escrita falha em vez de sobrescrever em silêncio. - Paginação por cursor opaco e erros com código estável, para o cliente tratar por código e nunca por texto.
- Rotas que só fazem sentido para a sessão do app ficam fora da documentação pública, de propósito.
Detalhes técnicos: 58 ferramentas MCP, cada uma presa a uma operação RESTstdio · cliente não confiável
O servidor MCP é um processo Node.js 24 com o SDK oficial, falando por stdio. Ele se autentica com uma chave de serviço do workspace e se comporta como um cliente REST não confiável: não importa o pacote de banco, não abre conexão com o PostgreSQL e não tem regra de negócio. Workspace e autor da ação vêm sempre da autenticação, nunca do que o agente mandou.
São 58 ferramentas em seis grupos: inspeção do workspace, funis e etapas, leads, negócios, campos customizados (seções, definições e opções) e automações com suas execuções. Cada ferramenta aponta para uma operação REST canônica, declara o escopo exigido e se lê ou altera dados. Não existe ferramenta genérica de HTTP, SQL ou execução de código.
Executar e simular uma automação são ferramentas diferentes, e a simulação é classificada como leitura. Um agente com chave só de leitura pode testar fluxos à vontade sem efeito real. Mutações não são repetidas às cegas, o stdout fica reservado para o protocolo e o diagnóstico vai para o stderr já sem credenciais, prompts ou corpos de resposta. Interpretação de linguagem, planejamento e aprovação do operador ficam com o agente.
Meu papel
Fiz tudo: visão de produto, arquitetura, código, testes, deploy e operação. Os 621 commits do repositório, de 20 de agosto a 18 de outubro de 2026, são meus. O desenvolvimento é guiado por especificações e ADRs e acelerado por agentes de IA: cada decisão relevante fica registrada antes de virar código, o que manteve 48 decisões coerentes em 8 semanas. São 96 migrações SQL e 10 workflows de CI, a maioria em runners próprios.
Resultado
- Leads, negócios, empresas, contatos, tarefas e produtos nativos, campos customizados, múltiplos funis com etapas abertas, ganhas e perdidas, kanban, tabela e dashboards salvos.
- Automação visual persistente com canvas, simulação segura, trilha de execução, esperas duráveis e cadências em dias úteis.
- API REST com OpenAPI, chaves de serviço com escopo, webhooks de entrada e saída e servidor MCP para agentes de IA.
- Operação de SaaS: planos com limites por workspace, backups criptografados e verificados, retenção de dados pessoais executada pelo worker, perfis de acesso granulares e login com Google e Microsoft.
O que eu faria diferente
- Gerar o contrato entre canvas e kernel em vez de manter cópias sincronizadas à mão entre o app web e o pacote do motor.
- Ter disciplina de numeração de ADRs desde o primeiro dia. A velocidade gerou números duplicados; é pouco, mas é o tipo de ruído que um processo guiado por documentos não deveria ter.